1. 什么是冒泡排序
冒泡排序是一种最基础的交换排序算法。主要用于小规模数据排序、教学演示,以及在数据基本有序的场景下进行快速修正。
2. 核心思想
重复遍历待排序的序列,依次比较相邻的两个元素,如果它们的顺序错误(比如前大后小)就交换过来。每一次完整的遍历,都会让当前未排序部分中最大的那个元素像"气泡"一样,逐渐"浮"到序列的最末端。
3. 算法执行过程
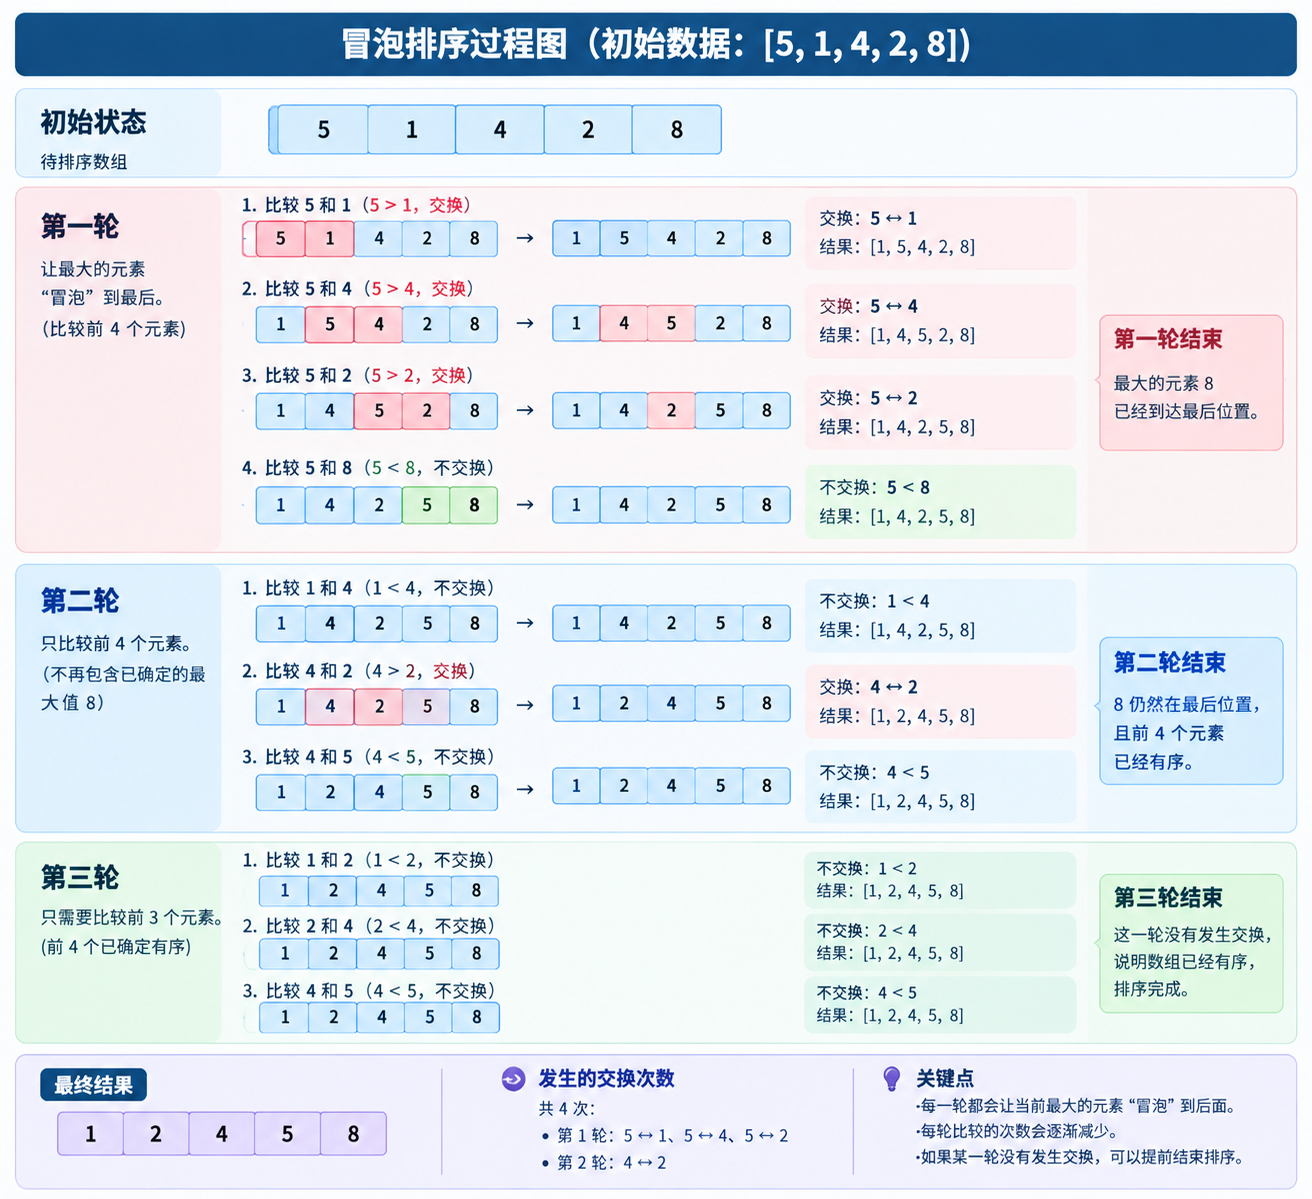
重复遍历数组,依次比较相邻元素,把大的往后交换,每轮确定一个最大数放到末尾,直到全部排好。
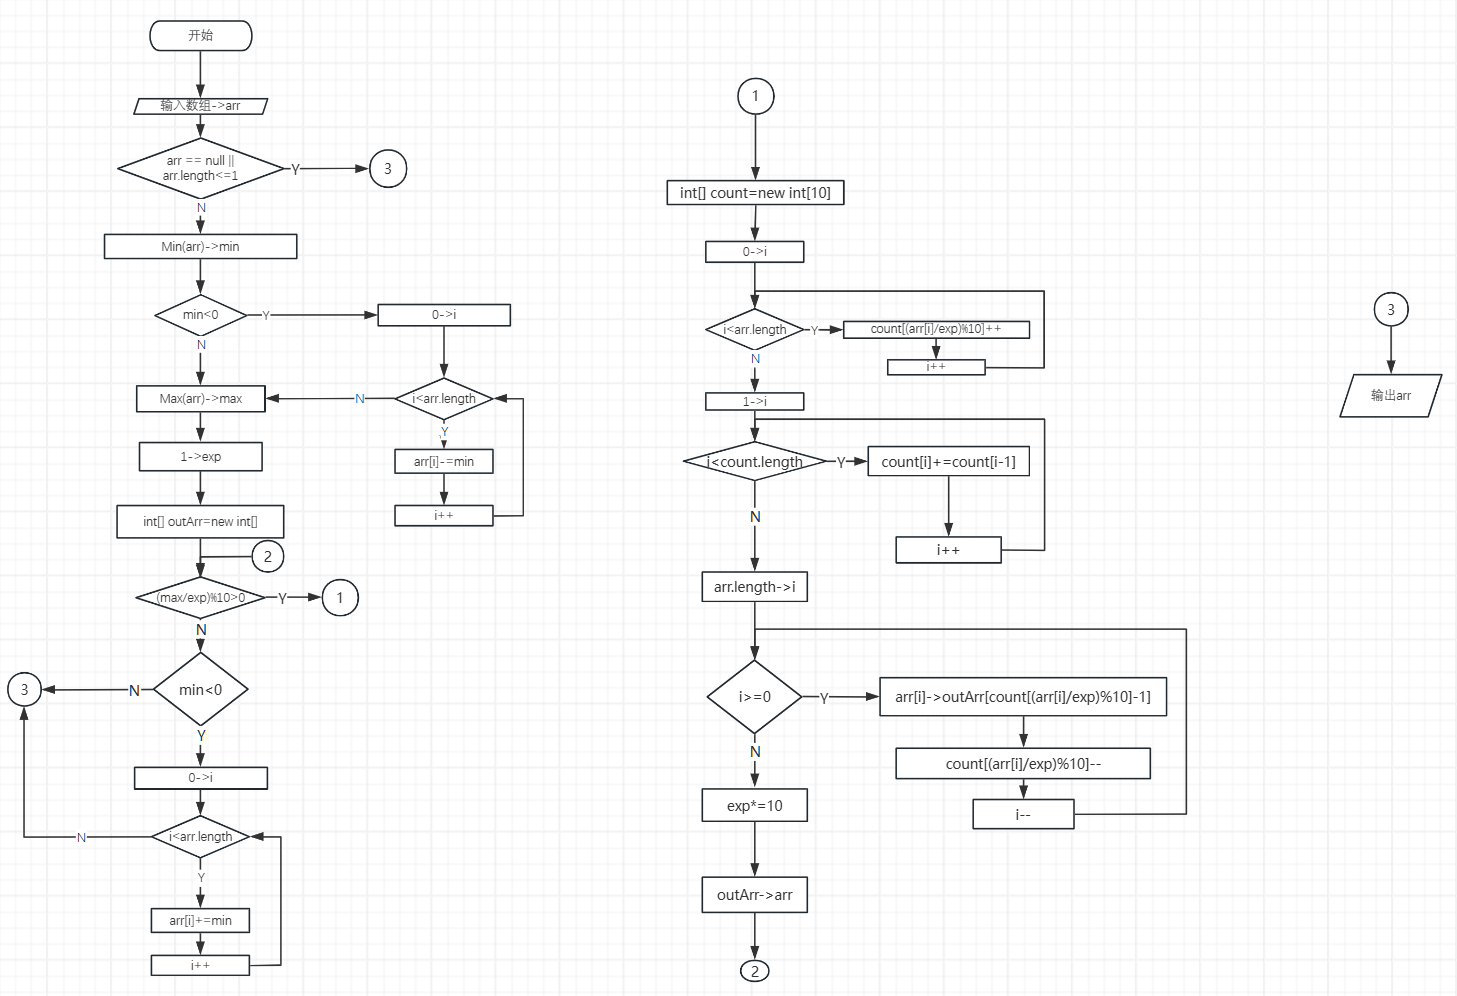
4. 流程图
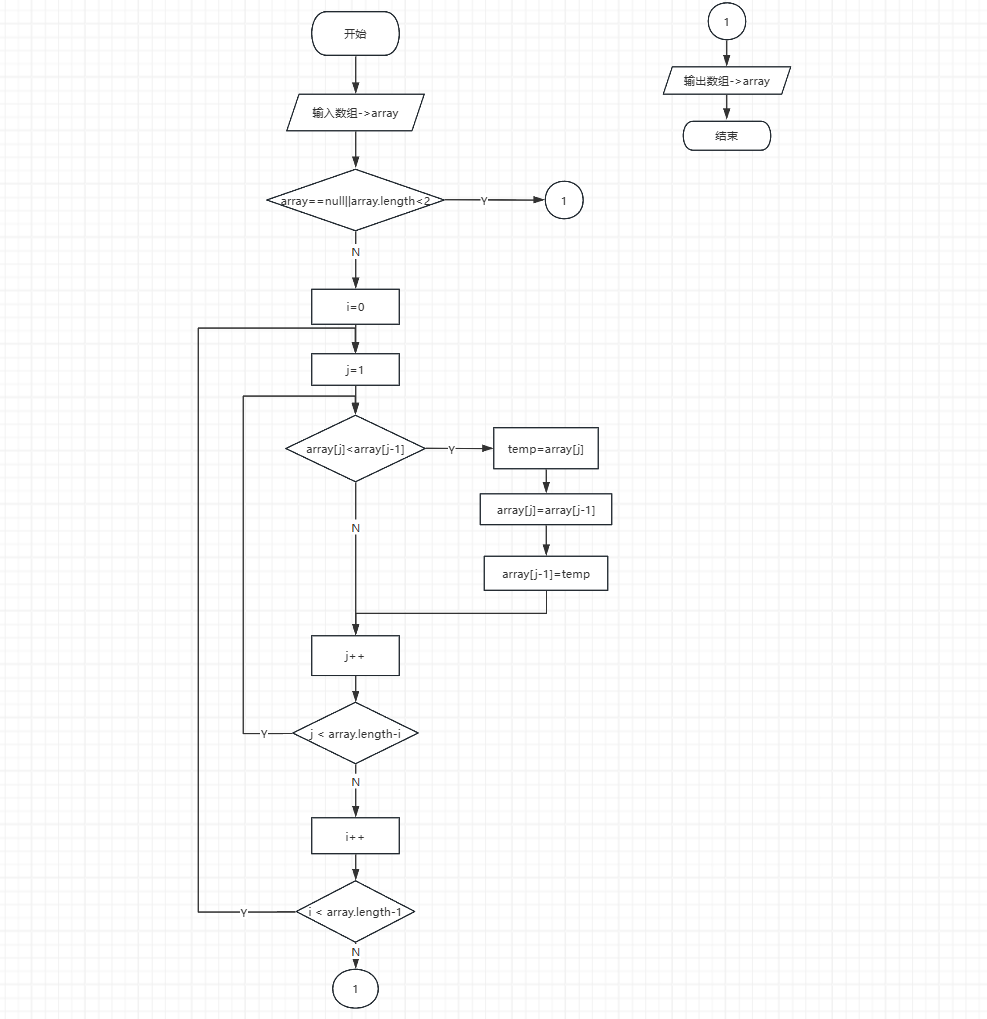
5. Java 实现
public int[] bubbleSort(int[] array){
        if(array==null||array.length<2){
            return array;
        }
        //1.外层循环
        for (int i = 0; i < array.length-1; i++) {
            //2.内层循环
            for (int j = 1; j < array.length-i; j++) {
                if(array[j]<array[j-1]){
                    int temp=array[j];
                    array[j]=array[j-1];
                    array[j-1]=temp;
                }
            }
        }
        return array;
    }
6. 代码逐段解析
6.1外层循环功能
决定总共需要进行多少轮"冒泡"。
6.2内层循环功能
在每一轮中,从左到右扫描未排序部分,完成相邻元素的比较和交换。
7. 复杂度分析
冒泡排序的复杂度分析
冒泡排序是一种基于比较和交换的排序算法。它的核心操作是比较相邻元素并在逆序时进行交换。假设:
n:数组中元素的个数
时间复杂度:O(n²)
1. 比较次数
冒泡排序通过两层循环完成排序:
外层循环:执行
n-1轮内层循环:第
i轮需要比较n-1-i次
总的比较次数为:
text
(n-1) + (n-2) + (n-3) + ... + 2 + 1 = n(n-1)/2所以比较次数为:O(n²)
时间复杂度:O(1)
冒泡排序是原地排序算法:
只使用了常数级别的额外空间
只需要一个临时变量
temp用于交换元素
text
额外空间 = 1 个临时变量(常数级)因此空间复杂度为:O(1)
8. 优缺点及应用
优点
冒泡排序实现非常简单,代码只有几行,不容易写错。它是稳定排序,相等元素顺序不变,适合多字段排序。空间复杂度是O(1),只需要一个临时变量,几乎不占额外内存。加上优化标志后,数据基本有序时效率很高,最快可达O(n)。还能用来检测数组是否有序,一趟扫描没交换就说明已经排好了。代码简单也意味着调试方便,出问题很容易定位。
缺点
冒泡排序平均效率太低,时间复杂度是O(n²),数据量稍大性能就急剧下降。最坏情况下比较和交换次数都达到最大,运行非常慢。十万个数据需要约五十亿次比较,实践中完全不可接受。每发现一个逆序对就要交换一次,数据移动开销也大。忘记加优化标志效率会更差。在所有常见排序算法中,冒泡排序的综合性能是最差的之一。
应用场景
冒泡排序最常用于教学,适合初学者理解排序的基本概念。实际开发中主要用于数据量很小的场景,比如元素少于五十个,简单比效率更重要。数据基本有序时,配合优化标志只要几轮就能完成。在嵌入式系统等资源受限环境中,它不占内存、不需要递归,比较可靠。单向链表上排序时,冒泡比快排实现更方便。还可以用来检测数组是否有序,或者只找出最大的几个数。
9. 总结
冒泡排序通过相邻元素比较交换,让最大值逐轮"浮"到末尾,n个元素需n-1轮。平均时间复杂度O(n²),空间O(1),稳定排序。优点是简单省内存,缺点是效率低。主要用于教学、小数据量(n<50)和资源受限场景,大数据请用快速排序。简单但不够快,适合入门学习。