1. 什么是基数排序
基数排序是一种非比较排序算法,它通过按照数字的不同位进行多轮排序,最终得到有序结果。主要用于对整数、字符串等具有明确位结构的数据进行排序。
2. 核心思想
是从数字的低(高)位到高(低)位逐位进行排序
个位->十位->百位->...3. 算法执行过程
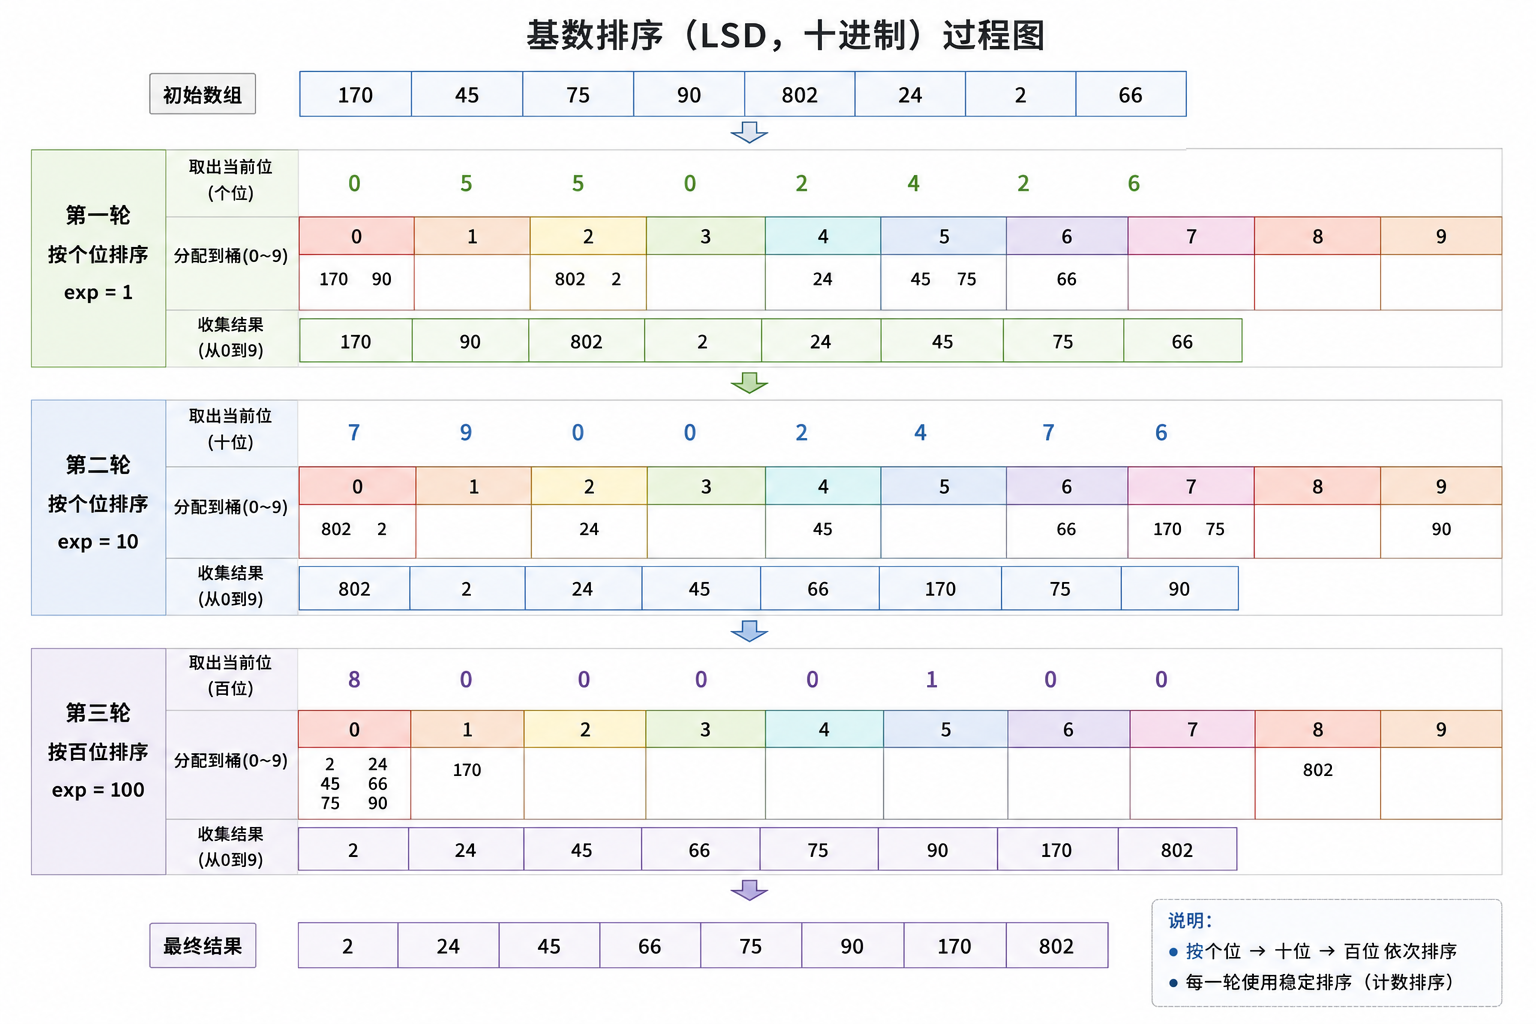
LSD 基数排序从最低位开始,依次对个位、十位、百位进行稳定排序。每一轮只处理当前位,上一轮已经建立的相对顺序会被保留下来。经过最高位排序后,整个数组最终有序。
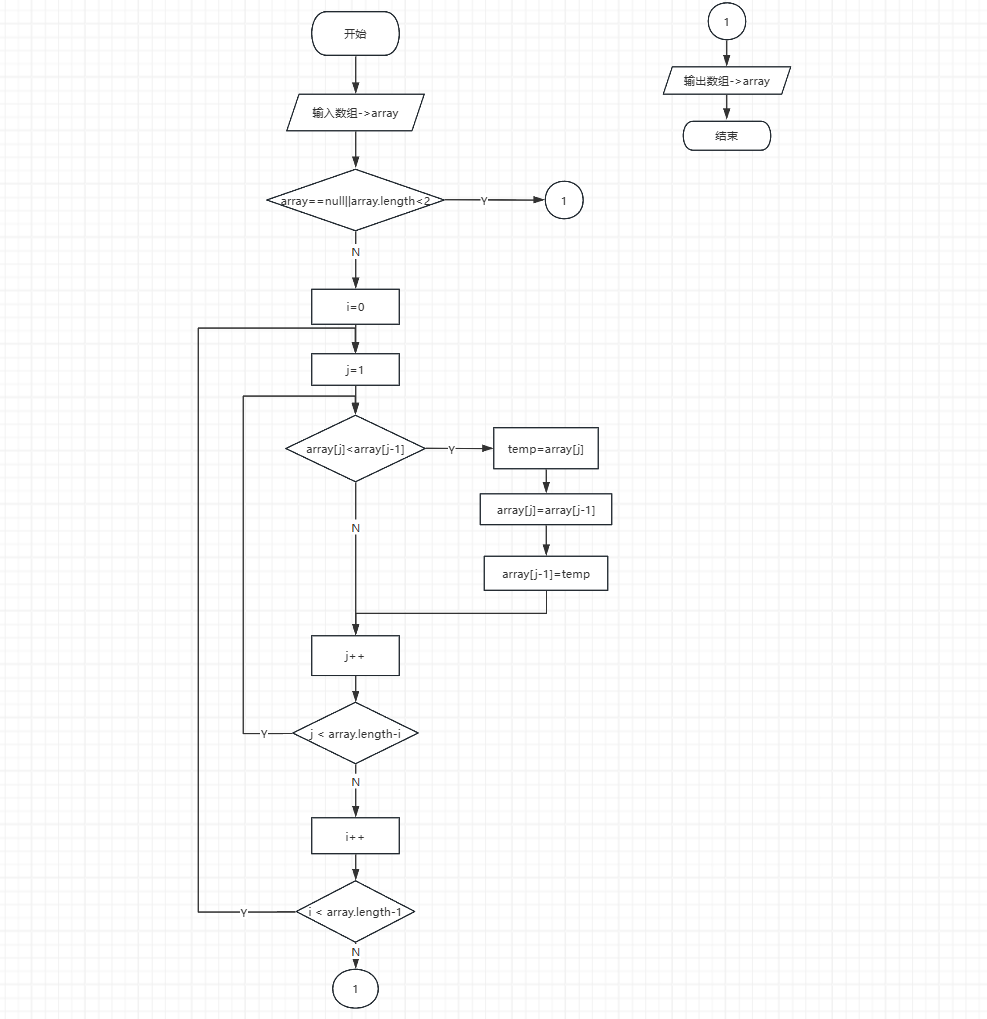
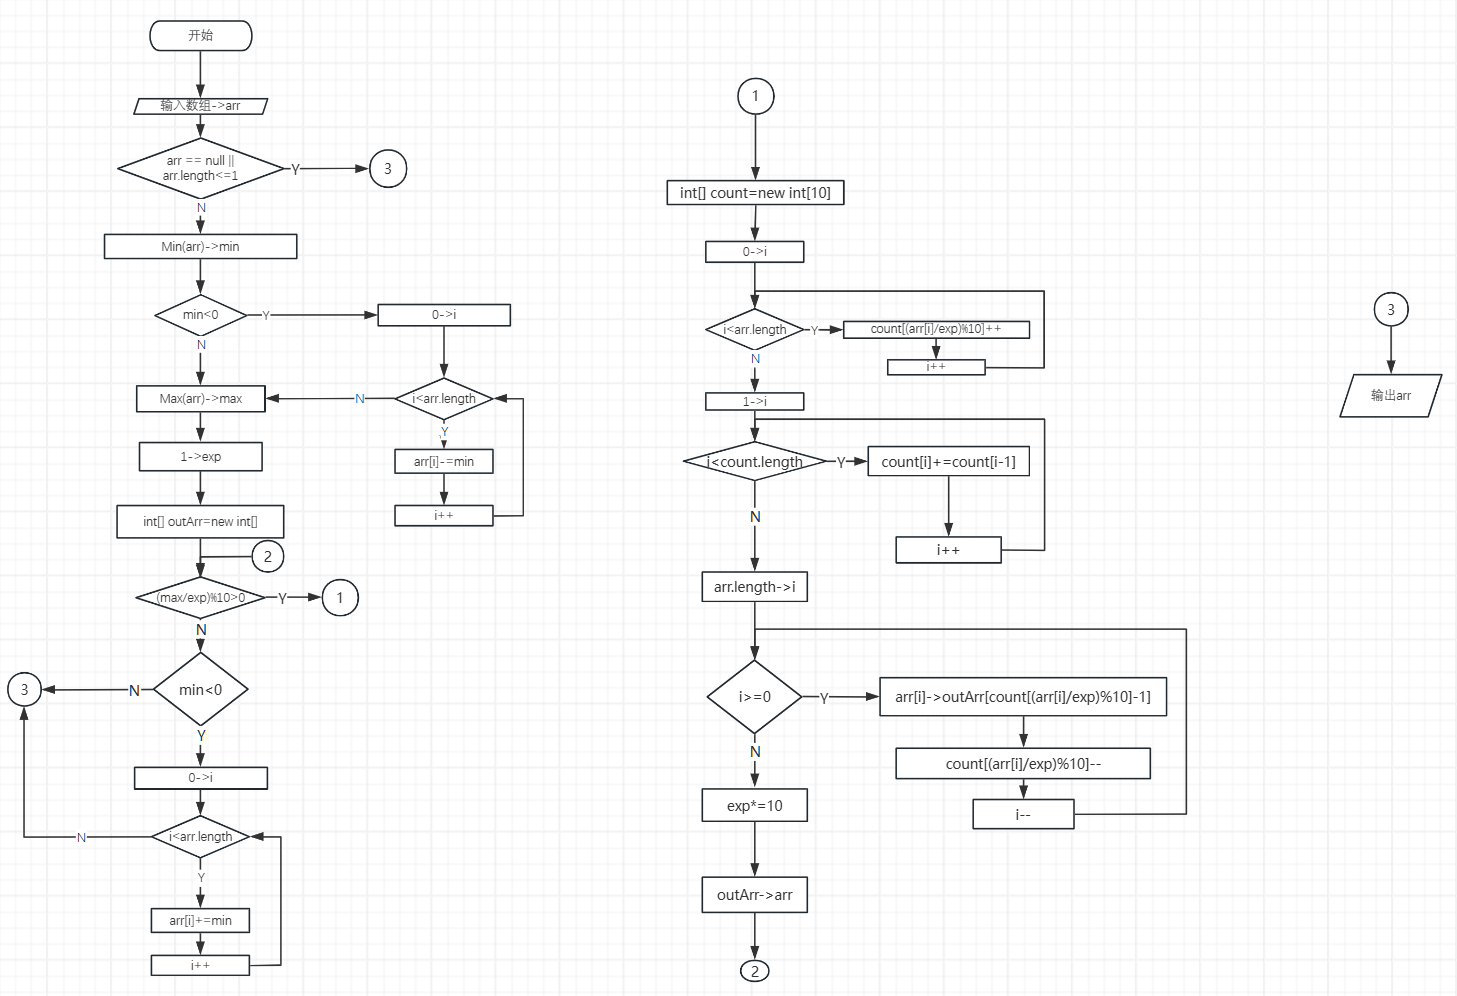
4. 流程图
5. Java 实现
public static int[] radixSort(int[] arr) {
        //1.边界判断与负数处理
        if (arr == null || arr.length <= 1) return arr;
        int min = Arrays.stream(arr).min().getAsInt();
        if (min < 0) {
            for (int i = 0; i < arr.length; i++) {
                arr[i] -= min;
            }
        }
        //2.初始化排序参数
        int max = Arrays.stream(arr).max().getAsInt();
        int exp = 1;
        int[] outArr = new int[arr.length];
        //3.按当前位进行计数排序
        while (max / exp > 0) {
            int[] count = new int[10];
            for (int num : arr) {
                count[(num / exp) % 10]++;
            }
            for (int i = 1; i < count.length; i++) {
                count[i] += count[i - 1];
            }
            for (int i = arr.length - 1; i >= 0; i--) {
                outArr[count[(arr[i] / exp) % 10] - 1] = arr[i];
                count[(arr[i] / exp) % 10]--;
            }
            arr = outArr;
            exp *= 10;
        }
        //4.恢复负数
        if (min < 0) {
            for (int i = 0; i < arr.length; i++) {
                arr[i] += min;
            }
        }
        return arr;
    }
6. 代码逐段解析
6.1 为什么要进行负数处理
基数排序需要逐位提取元素的数值,而当前实现中的数位提取公式 (num / exp) % 10 是针对非负整数设计的。对于负数,直接进行数位提取会产生不符合预期的结果。因此,当数组中存在负数时,可以先找到最小值 min,并将每个元素减去 min,使整个数组中的元素都变为非负数。完成基数排序后,再将 min 加回每个元素,从而恢复原始数据。
6.2 初始化排序参数
max 用于确定排序所需的最高位,exp 用于控制当前处理的数位,而 outArr 用于保存每一轮稳定计数排序产生的临时结果。
6.3 按当前位进行计数排序详解
第1个循环:统计每个数字出现的次数
for (int num : arr) {
    count[(num / exp) % 10]++;
}
作用
统计当前这一位上,0~9 每个数字出现了多少次。
例如:
21 → 个位是 1
15 → 个位是 5
33 → 个位是 3
12 → 个位是 2
所以 count 数组变成:
第2个循环:计算每个数字应该放到哪里
for (int i = 1; i < count.length; i++) {
    count[i] += count[i - 1];
}
作用
把“数量”变成“位置”。
原来的 count:
累加以后:
这里的 count[i] 表示:
“当前数字放完以后,应该占到
outArr的哪个位置。”
注意:
代码中的位置是从 1 开始算的,但是数组下标从 0 开始,所以后面真正放的时候要写:
count[...] - 1第3个循环:按照位置把元素放进 outArr
for (int i = arr.length - 1; i >= 0; i--) {
    outArr[count[(arr[i] / exp) % 10] - 1] = arr[i];
    count[(arr[i] / exp) % 10]--;
}
作用
根据 count 算出来的位置,把 arr 中的数字真正放到 outArr 中。
例如:
21 → 个位是 1
count[1] = 1
所以:
outArr[1 - 1] = 21;也就是:
outArr[0] = 21;然后:
count[1]--;变成:
count[1] = 0这样下一个个位是 1 的数字,就会继续往前放。
为什么从后往前遍历?
因为这样可以保证相同数字的原始顺序不变,也就是保证排序的稳定性。
三个循环整体理解
第1个循环:统计数量
count = “每种数字有几个”↓
第2个循环:计算位置
count = “每种数字应该放到哪里”↓
第3个循环:真正放入 outArr
outArr = “排好当前这一位之后的数组”所以可以简单记:
第1步:数有几个
第2步:算放哪里
第3步:真的放进去
也就是:
统计 → 定位 → 搬家
7. 复杂度分析
基数排序本身不直接比较元素大小,而是逐位进行排序。假设:
n:数组中元素的个数k:元素的最大位数10:每一位可能出现的数字个数
每一位使用计数排序时,需要遍历一次数组,同时遍历长度为 10 的 count 数组,因此单次排序的时间复杂度为:
O(n + 10) = O(n)一共需要处理 k 位,所以基数排序的时间复杂度为:
O(k × n)如果把 10 看作常数,那么通常直接写成:
时间复杂度:O(kn)
空间方面,需要额外使用:
count[10]:大小固定为10outArr[n]:用于保存排序结果
因此空间复杂度为:O(n)
另外,这段代码中的负数处理不会改变整体的时间复杂度,因为对数组进行减法和恢复也只是遍历一次数组。
8. 优缺点及应用
优点
1. 时间复杂度比较稳定
基数排序不依赖元素之间的比较,时间复杂度主要取决于元素个数 n 和位数 k。
O(kn)当 k 较小且固定时,可以近似看成:
O(n)2. 适合处理大量整数
对于位数比较固定的整数,基数排序效率比较高。
3. 可以保持稳定性
基数排序通常使用稳定的计数排序作为每一位的排序方法。
这也是为什么代码中第三个循环要从后往前遍历。
缺点
1. 不是所有数据都适合
如果数据的位数 k 很大,那么需要进行很多轮排序,效率就会下降。
2. 需要额外的空间
排序过程中需要使用 count 数组和 outArr 数组,因此不是原地排序。
空间复杂度为:
O(n)3. 实现比普通比较排序复杂
基数排序需要考虑:
每一位如何提取
count数组如何统计如何保证稳定性
正负数如何处理
溢出等问题
因此代码理解起来会比快速排序、归并排序等算法更加复杂。
应用场景
基数排序比较适合:
整数排序
固定长度的数字排序
学号、编号等具有明显位数特征的数据
大量数据且数据位数比较固定的场景
字符串排序(可以按照字符逐位处理)
例如:
学生编号:20260101
        20260315
        20260023
        20261234
这类数据具有比较明显的“位数”特征,就比较适合使用基数排序。
9. 总结
基数排序的核心思想可以概括为:
不直接比较两个数字的大小,而是从低位到高位,逐位进行排序。
例如:
个位 → 十位 → 百位 → 千位 → ...每一位的排序通常使用计数排序完成。
其中 count 数组是整个过程的关键:
第1步:统计数量
    ↓
每个数字出现了多少次

第2步:计算位置
    ↓
每个数字应该放在哪里

第3步:放入结果数组
    ↓
完成当前这一位的排序
因此可以把基数排序简单理解为:
逐位处理 + 计数排序 + 保持稳定
它的平均时间复杂度为:
O(kn)空间复杂度为:
O(n)当数据量较大、数字位数较固定时,基数排序可以表现出很好的效率;但如果数据位数很大,或者数据类型并不适合按位处理,那么使用其他排序算法可能更加合适。